

빌려 쓰는 AI에서 길러 쓰는 AI로, LLM 사후학습은 어떻게 할까?
2026.10.02
잇뉴는 최근 사내 기술 리뷰를 진행했습니다. 이번 리뷰는 제주산학융합원과 한국전자통신연구원(ETRI)이 진행한 「LLM 파인튜닝 기반 맞춤형 AI 모델 배포 실무 과정」을 수강한 온 팀원이 교육 내용을 바탕으로 직접 자료를 만들고, 다른 팀원들에게 핵심 개념과 실무 적용 방법을 공유하는 자리였습니다.
AI를 업무에 활용하는 방식은 크게 두 가지로 나눌 수 있습니다.
하나는 거대한 모델을 API로 빌려 쓰는 방식이고, 다른 하나는 공개된 모델을 가져와 우리 목적에 맞게 다듬는 방식입니다.
이번 글에서는 리뷰에서 다룬 내용을 바탕으로, LLM을 우리 일에 맞게 ‘기르는’ 세 가지 방법을 정리해 봅니다.
LLM은 결국 ‘다음 단어’를 맞힌다
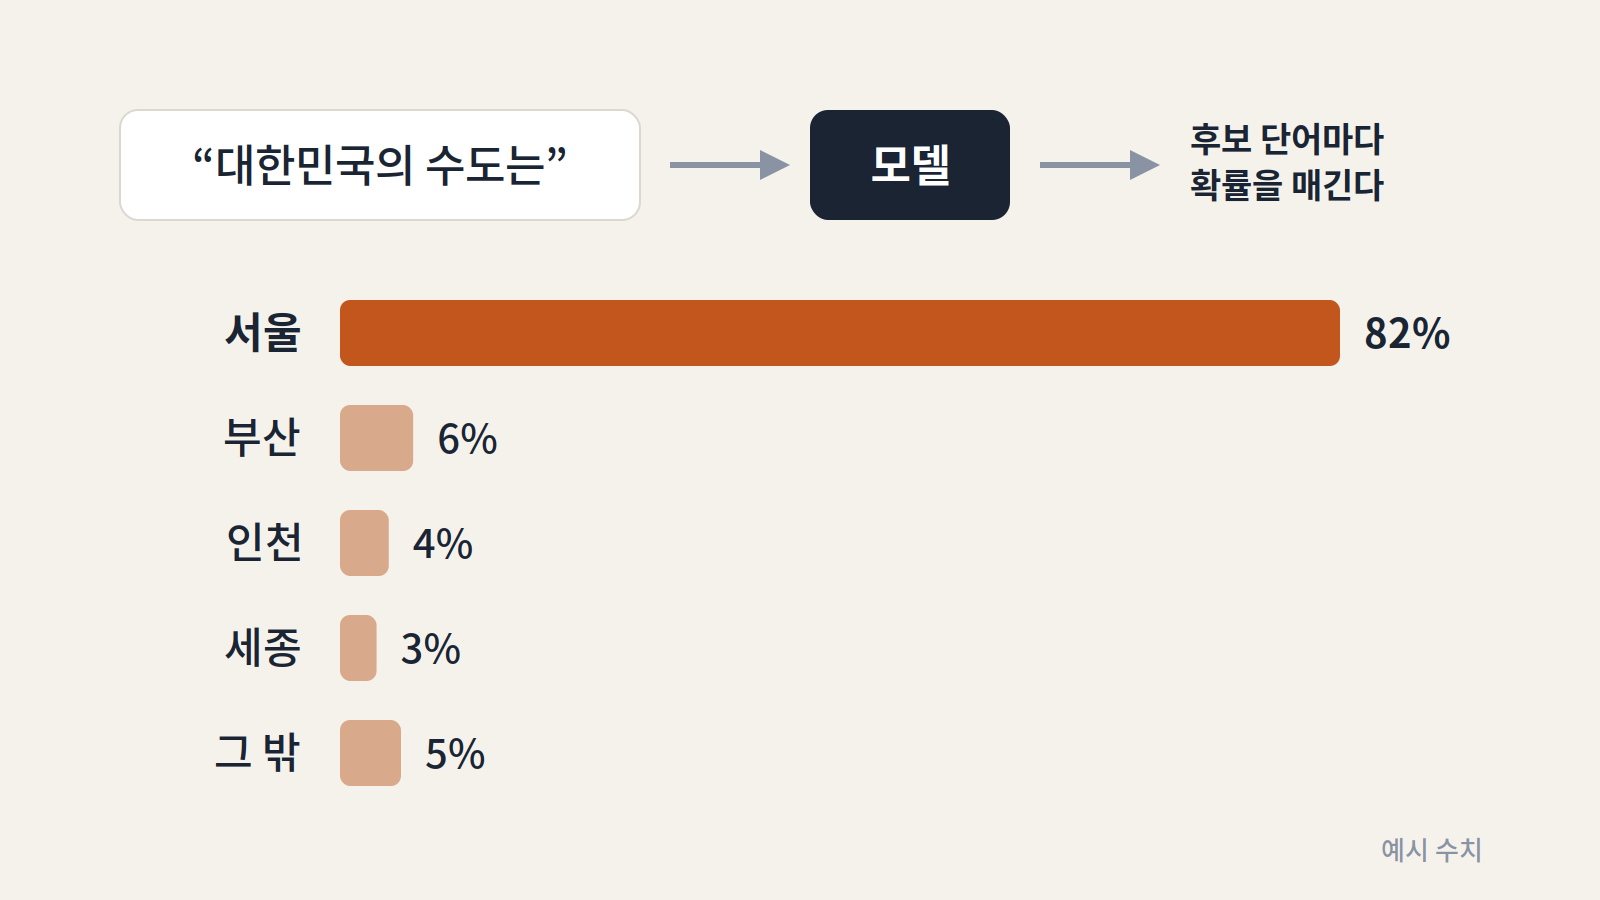
LLM, 즉 대규모 언어 모델이 하는 일은 생각보다 단순합니다. 지금까지 나온 문장을 보고 다음에 올 단어를 예측하는 것입니다. 휴대폰 자동완성의 훨씬 똑똑한 버전이라고 생각하면 이해하기 쉽습니다.
예를 들어 “대한민국의 수도는”이라는 문장이 주어지면, 모델은 다음 단어 후보들에 각각 확률을 매깁니다. 이때 ‘서울’이 가장 높은 확률을 받으면 모델은 ‘서울’을 이어 씁니다.
오늘 다룰 세 가지 방법도 본질적으로는 모두 같습니다. 모델이 특정 상황에서 더 적절한 단어에 더 높은 확률을 주도록 바꾸는 방법입니다.
LLM은 보통 두 단계를 거쳐 만들어집니다.
첫 번째는 사전학습(Pretraining) 입니다. 모델이 인터넷의 방대한 글을 읽으며 언어와 지식을 배우는 단계입니다. 이 과정에는 막대한 비용이 듭니다. 예를 들어 Meta의 Llama 3.1 405B는 학습에 H100 GPU 약 1만 6천 장을 사용한 것으로 알려져 있고, 비교적 작은 모델인 Qwen3 0.6B도 36조 토큰 규모의 데이터를 학습했습니다.
두 번째는 사후학습(Post-training) 입니다. 이미 말을 할 줄 아는 모델을 특정 목적에 맞게 다듬는 단계입니다. 흔히 말하는 파인튜닝도 여기에 포함됩니다. 사전학습과 달리, 사후학습은 훨씬 작은 비용으로도 시도해 볼 수 있습니다. 경우에 따라 GPU 한 장으로도 실험이 가능합니다.
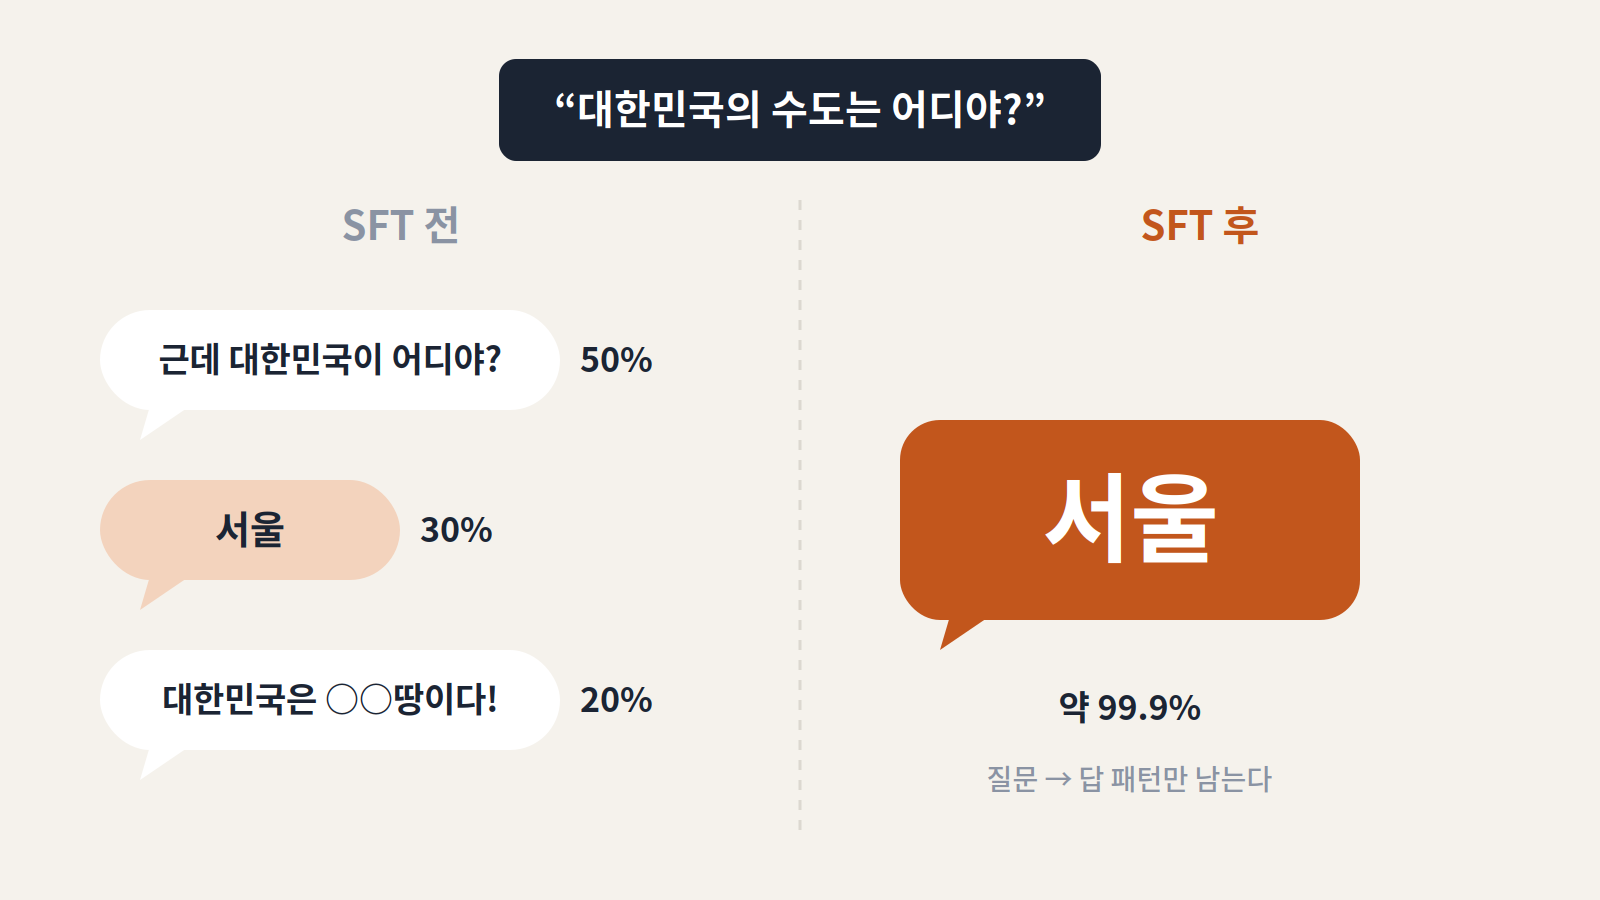
사후학습이 필요한 이유는 명확합니다. 사전학습만 마친 베이스 모델은 질문을 ‘답해야 할 요청’이 아니라 ‘이어 써야 할 글’로 볼 수 있습니다. 예를 들어 “대한민국의 수도는?”이라고 물었을 때, “일본의 수도는? 중국의 수도는?”처럼 비슷한 문제를 계속 만들어낼 수 있습니다. 말을 이어 쓰는 능력은 있지만, 우리가 원하는 방식으로 대답하는 능력은 아직 부족한 상태입니다.
모델을 기르는 세 가지 방법
1. SFT : 모범답안을 따라 쓰게 하기
SFT는 Supervised Fine-Tuning, 즉 지도 파인튜닝입니다. 모델에게 ‘질문–모범답안’ 쌍을 보여 주며 추가로 학습시키는 방법입니다.
원리는 여전히 다음 단어 맞히기입니다. 다만 아무 글이나 이어 쓰게 하는 것이 아니라, 특정 질문 뒤에는 우리가 원하는 답변이 오도록 반복해서 보여 줍니다.
인터넷에는 질문 뒤에 또 다른 질문이 이어지는 글도 있고, 엉뚱한 답변이 이어지는 글도 있습니다. SFT는 그중에서 “질문이 오면 답을 한다”는 패턴을 강하게 학습시킵니다. 고객 문의 응대 문장 수백~수천 쌍만 있어도 회사의 말투, 답변 형식, 자주 쓰는 표현을 어느 정도 익힐 수 있습니다.
2. 강화학습 : 직접 풀고 채점받게 하기
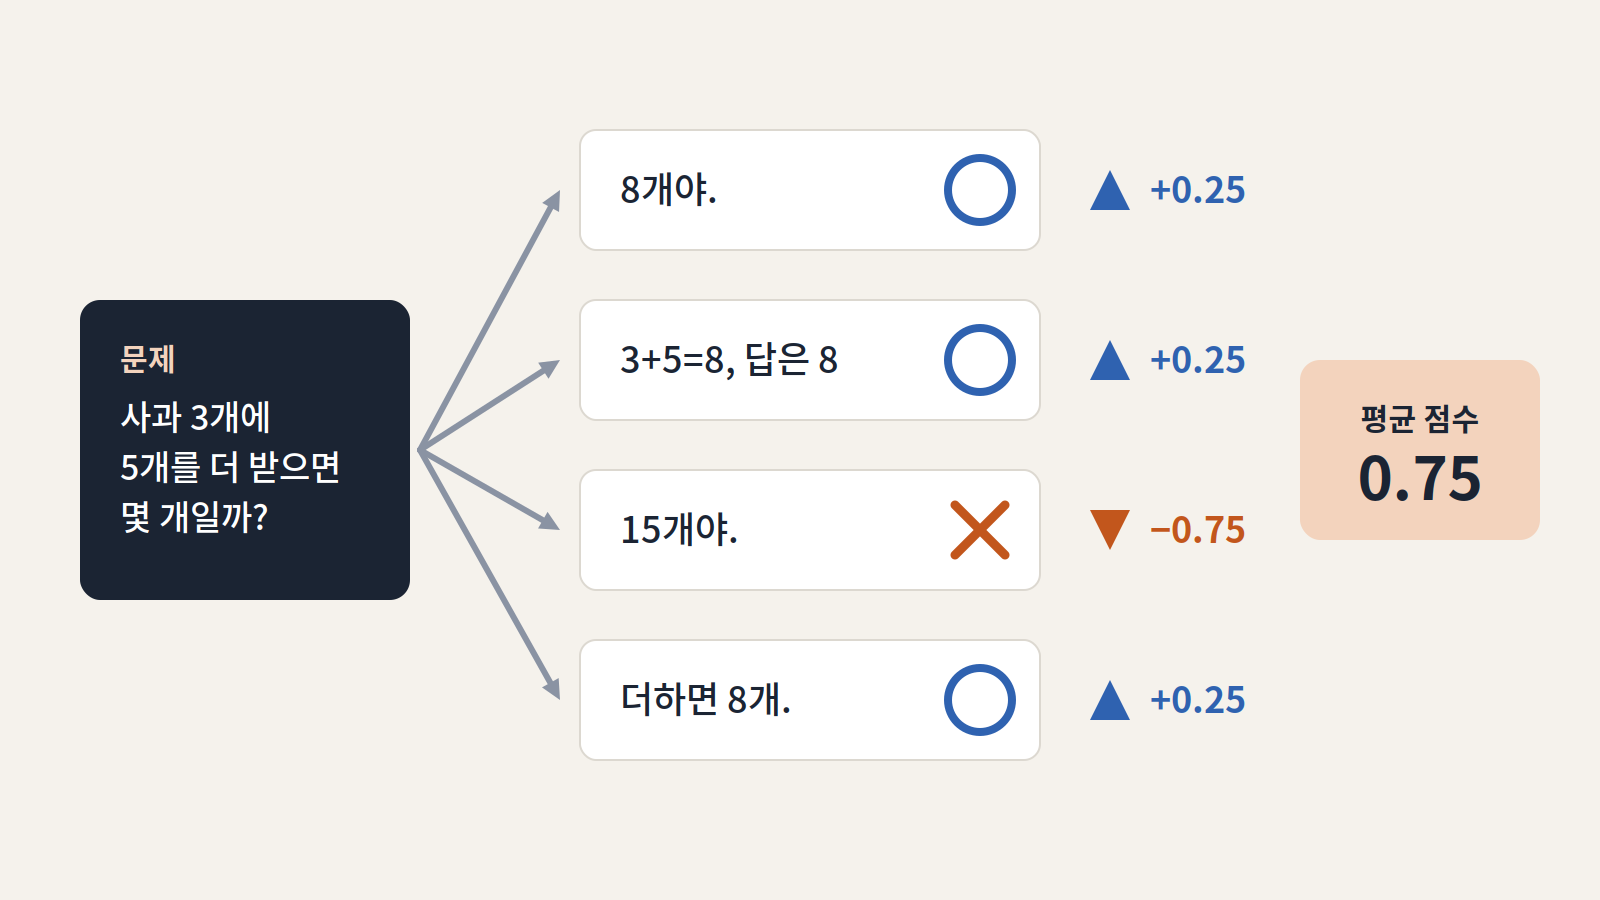
강화학습은 모범답안을 그대로 보여 주는 대신, 모델이 낸 답에 점수를 주는 방식입니다. 모델은 여러 번 답을 만들어 보고, 좋은 점수를 받은 방향으로 점점 더 가까워집니다.
이번 리뷰에서는 그중에서도 RLVR을 중심으로 다뤘습니다. RLVR은 Reinforcement Learning with Verifiable Rewards의 약자로, 검증 가능한 보상을 사용하는 강화학습입니다.
핵심은 사람이 주관적으로 점수를 매기는 대신, 컴퓨터가 정답 여부를 자동으로 확인한다는 점입니다. 수학 문제라면 계산 결과를 대입해 볼 수 있고, 코드 문제라면 실제로 실행해 테스트를 통과하는지 확인할 수 있습니다. 채점이 빠르고, 기준이 비교적 명확하다는 장점이 있습니다.
대표적인 방법인 GRPO는 같은 문제를 여러 번 풀게 한 뒤, 평균보다 잘한 답을 더 강화합니다. 예를 들어 같은 문제를 네 번 풀어 세 번 맞히고 한 번 틀렸다면 평균 점수는 0.75가 됩니다. 맞힌 답은 평균보다 좋으므로 강화되고, 틀린 답은 평균보다 낮으므로 약화됩니다.
흥미로운 점은 모두 맞히거나 모두 틀리는 문제에서는 배울 것이 별로 없다는 것입니다. 비교할 대상이 없기 때문입니다. 그래서 강화학습에는 너무 쉽지도, 너무 어렵지도 않은 문제가 중요합니다.
3. 지식증류 : 선생 모델의 답을 물려받게 하기
지식증류는 큰 모델을 ‘선생’, 작은 모델을 ‘학생’으로 두고 학습시키는 방법입니다. 큰 모델이 만든 답변을 작은 모델의 학습 데이터로 사용하는 방식입니다.
학습 방식 자체는 SFT와 비슷합니다. 다만 모범답안을 사람이 직접 만들지 않고, 성능이 좋은 큰 모델이 만들어 준다는 점이 다릅니다.
선생 모델은 정답뿐 아니라 확신의 정도도 학생 모델에게 전달할 수 있습니다. 예를 들어 어떤 대상이 과일일 가능성과 채소일 가능성을 각각 어느 정도로 보는지까지 학생이 배울 수 있습니다. 큰 모델은 성능이 좋지만 비용이 높고 느릴 수 있습니다. 반면 작은 모델은 빠르고 운영 비용이 낮습니다. 지식증류는 이 차이를 활용하는 방법입니다.
다만 주의할 점도 있습니다. 학생 모델은 선생 모델의 좋은 답뿐 아니라 실수도 함께 배울 수 있습니다. 따라서 선생 모델이 만든 답을 그대로 쓰기보다, 품질을 검토하고 걸러 내는 과정이 필요합니다.
그렇다면 실무에서는 어떻게 고를까?
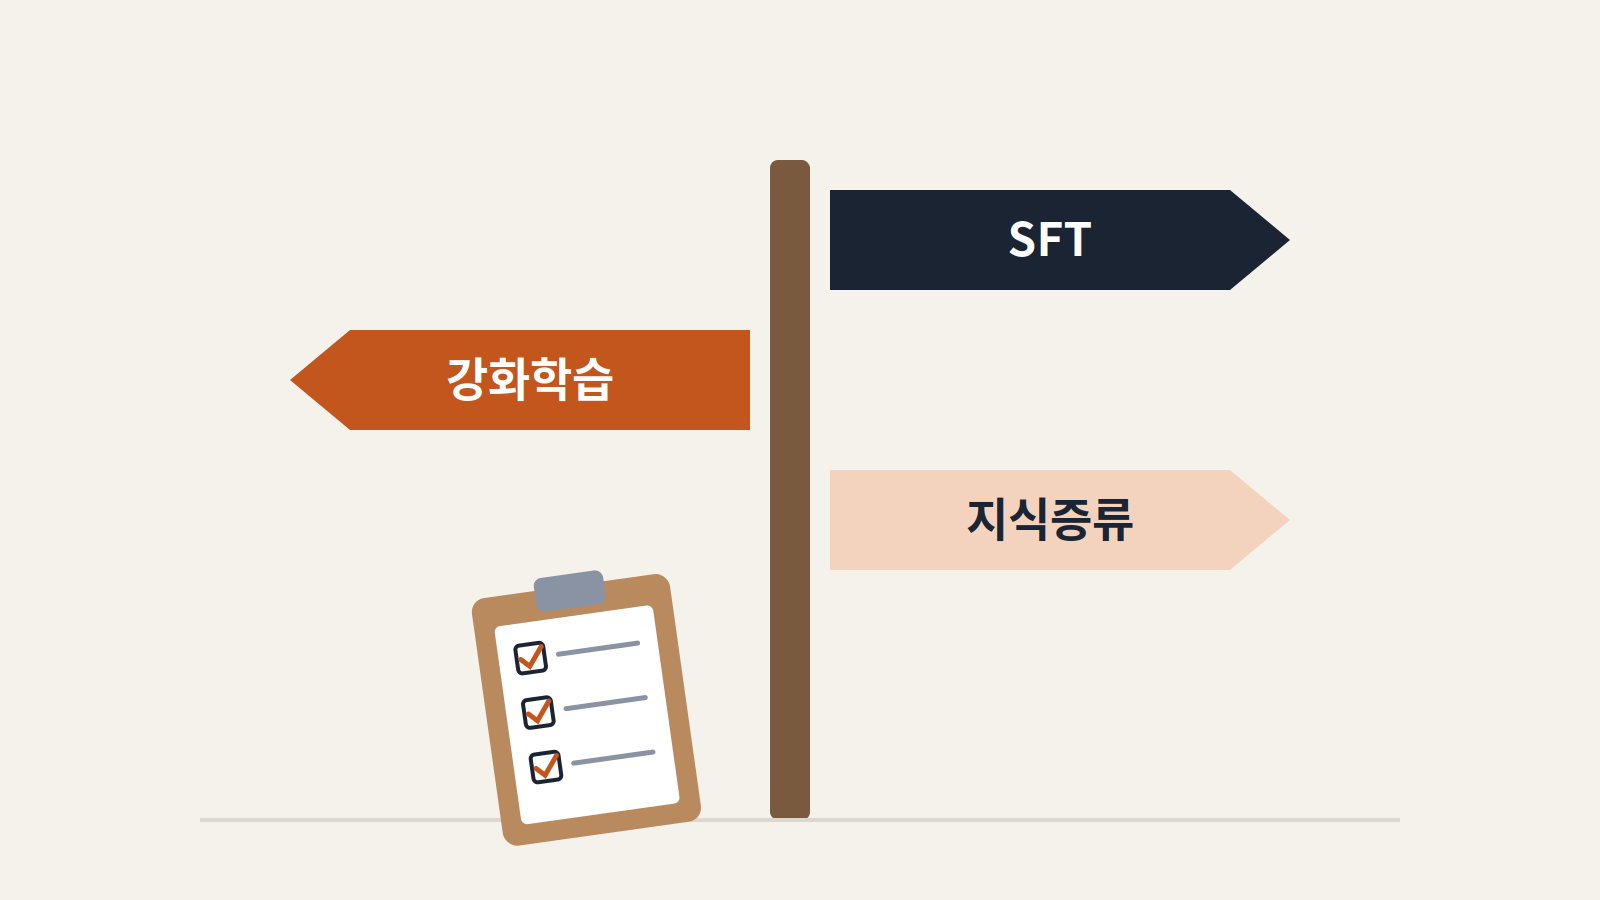
세 가지 방법은 목적에 따라 선택할 수 있습니다.
답변 형식, 말투, 사내 용어를 맞추고 싶다면 SFT가 좋은 출발점입니다.
다만 SFT만으로 모델의 실제 문제 해결 능력이 크게 좋아지는 것은 아닐 수 있습니다. 겉보기에는 그럴듯해졌지만, 어려운 문제를 푸는 능력은 그대로일 수 있습니다.
정답을 자동으로 채점할 수 있다면 강화학습을 고려할 수 있습니다.
계산, 코드, 규칙 판별처럼 결과를 명확히 검증할 수 있는 문제에 특히 잘 맞습니다. 다만 채점 기준에 빈틈이 있으면 모델이 그 빈틈을 이용할 수 있으므로, 보상 설계를 신중하게 해야 합니다.
작고 빠른 모델이 필요하다면 지식증류가 유용합니다.
큰 모델의 능력을 작은 모델에 옮겨 운영 비용과 응답 속도를 개선할 수 있습니다. 대신 선생 모델의 오답을 걸러 내는 품질 관리가 중요합니다.
이번 리뷰에서 가장 강조된 것은 특정 방법보다 순서였습니다. 어떤 방법을 쓰든 먼저 정해야 할 것은 “어떻게 학습시킬 것인가”가 아니라 “어떻게 평가할 것인가”입니다.
평가 기준이 없으면 모델이 좋아졌는지 판단할 수 없습니다. 모델을 기르기 전에, 어떤 답을 좋은 답으로 볼지 먼저 정해야 합니다.
마치며..
잇뉴는 이번 기술 리뷰를 통해 AI를 단순히 ‘가져다 쓰는 것’과 우리 목적에 맞게 ‘길러 쓰는 것’의 차이를 함께 살펴봤습니다.
LLM 사후학습은 거창한 연구실에서만 할 수 있는 일이 아닙니다. 목적을 분명히 정하고, 평가 기준을 세우고, 적절한 방법을 고른다면 실무에서도 충분히 실험해 볼 수 있는 영역입니다.
외부에서 배운 지식을 구성원이 직접 정리하고 공유하는 자리는 앞으로도 계속 이어갈 예정입니다. 다음 기술 리뷰에서 다룬 내용도 이 블로그를 통해 전하겠습니다.
감사합니다.